So übersetzt du ein gescanntes PDF und prüfst auf OCR-Fehler
Ein gescanntes PDF enthält Seitenbilder statt auswählbaren Text. Die OCR erkennt die Zeichen, bevor die Übersetzung beginnt. Eine Übersetzung kann flüssig klingen, auch wenn die OCR eine Zahl falsch gelesen oder Spalten zusammengeführt hat. Prüfe Quelle und Ausgabe immer nebeneinander.
Einen Ablauf passend zu deiner Datei wählen
| Was du siehst | Nächster Schritt |
|---|---|
| Text ist auswählbar, und kopierte Absätze werden in der richtigen Reihenfolge eingefügt. | Nutze den Ablauf für Text-PDFs. Teste eine Tabelle oder dichte Seite, bevor du die ganze Datei übersetzt. |
| Kein Text ist auswählbar. | Nutze den Ablauf für gescannte PDFs mit OCR. Vergleiche nach der Übersetzung Zeichen und Zahlen mit dem Originalbild. |
| Text ist auswählbar, aber Spalten werden beim Einfügen zusammengeführt. | Teste zuerst diese Seite. Auswählbarer Text garantiert keine korrekte Lesereihenfolge. |
| Die Datei enthält sowohl Textseiten als auch gescannte Seiten. | Teste eine Textseite und eine gescannte Seite. Prüfe beide Ausgaben, bevor du das ganze Dokument übersetzt. |
Zuerst prüfen, welche Seiten OCR brauchen
Markiere einen Satz und füge ihn in einen Nur-Text-Editor ein. Wenn du keinen Text markieren kannst, braucht die Seite wahrscheinlich OCR. Wenn der eingefügte Text verstümmelt ist oder Spalten vermischt, musst du auch die vorhandene Textebene genau prüfen. Da ein PDF Textseiten und Scans mischen kann, prüfe mehr als nur die erste Seite.
Eine kleine repräsentative Stichprobe vorbereiten
Nutze nur Seiten, die du hochladen darfst. Nimm für deinen ersten Test eine klare Seite, eine dichte Seite und eine Seite mit Tabelle. Drehe seitlich liegende Seiten und vermeide abgeschnittenen Text. Bewahre deine Originaldatei sicher auf. LangBox akzeptiert Dateien bis 100 MB ohne Seitenlimit, teile also nur Dateien über dieser Größe auf. Das Vergrößern eines unscharfen Scans stellt fehlende Zeichen nicht wieder her.
Übersetzen und die erste Ausgabe prüfen
Öffne den PDF-Übersetzer, melde dich an, wähle Quell- und Zielsprache und lade die Stichprobe hoch. Gescannte Seiten werden mit dem konfigurierten OCR-Dienst verarbeitet. Warte, bis der Auftrag fertig ist, und vergleiche dann die zweisprachige Ausgabe mit dem Original. Lade deine Datei innerhalb von 24 Stunden herunter. Dieser Ablauf ist ein Online-Dienst und läuft nicht offline.
Spalten, Tabellen und Zahlen prüfen
Lies einen ganzen Absatz von Anfang bis Ende, um zusammengeführte Spalten zu erkennen. Prüfe jede Zahl anhand ihrer Zeilenüberschrift, Spaltenüberschrift und Einheit. Vergleiche Minuszeichen, Dezimalpunkte, Datumsangaben und Verneinungen. Lies Formeln direkt aus der Originaldatei. In unserer archivierten Testdatei wurde CC0 als CCo falsch gelesen, und eine chinesische Einheit brach unglücklich um, obwohl der Auftrag ohne Fehler endete.
Was tun, wenn die Ausgabe unbrauchbar ist
Wenn sich Text überlagert, eine Spalte verschwindet oder Zahlen sich ändern, verwende die Ausgabe nicht. Versuche eine sauberere, autorisierte Quelle oder eine kleinere Stichprobe und prüfe das neue Ergebnis. Verlasse dich bei komplexen Tabellen oder Formeln auf das Originaldokument oder lass sie von einem Menschen prüfen. Ein erneuter Versuch mit einer Datei kann zusätzliches Guthaben verbrauchen und garantiert keine bessere Zeichenerkennung.
Was dieses Beispiel zeigt
Die herunterladbare Testdatei enthält eine Seite mit auswählbarem Text und eine passende gescannte Seite, dazu eine unbearbeitete Übersetzung. Sie zeigt konkrete Erfolge und Fehler auf genau diesen Seiten. Sie belegt keine Genauigkeit bei Handschrift, Scans von geringer Qualität, anderen Sprachen oder wissenschaftlichen Artikeln.
Echte PDF-Eingaben und -Ausgaben vergleichen
Dies sind archivierte LangBox-Ergebnisse aus der Produktivumgebung vom 20. September 2026, keine neuen Benchmark-Läufe. Öffne das Original und die unbearbeitete Ausgabe nebeneinander. Beurteile anhand der Beispiele unten, ob die Ausgabe zu deinem Dokument passt.
Dieselbe Seite als Scan
Seite 2 ist ein Bild von Seite 1. Der abschließende OCR-Neulauf hält die Absätze lesbar, aber aus CC0 wird CCo, und die Typografie ändert sich. Dieser Neulauf mit zwei Seiten nutzte GPT-5.6 Luna und dauerte etwa 96 Sekunden. Da er ein anderes Modell als der Prosatest nutzte, solltest du diese Zeiten nicht als Benchmark vergleichen.
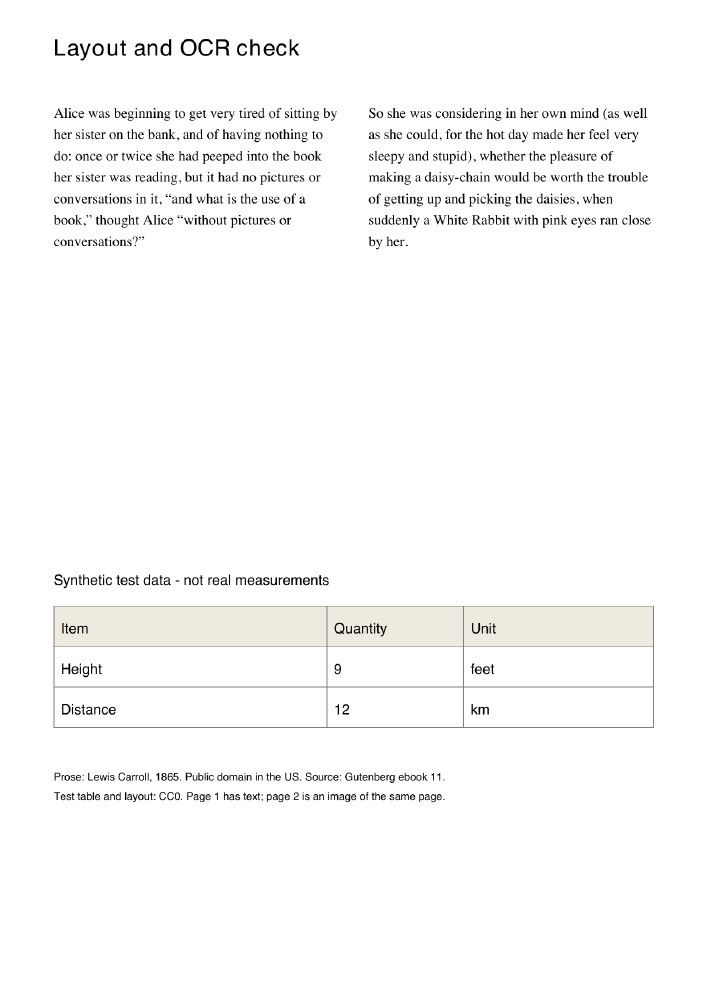
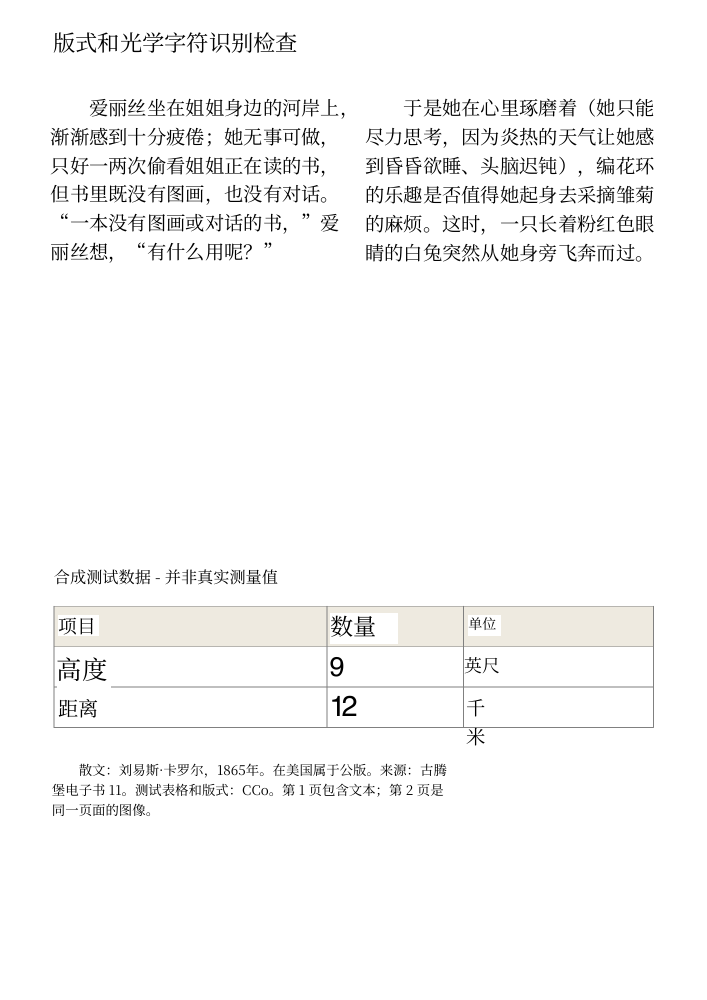
Klicke auf eine der Seiten, um das PDF zu öffnen. Quelle und Ausgabe stammen aus demselben archivierten Test.
Diese Details prüfen, bevor du einem Ergebnis vertraust
Vergleiche Namen, Verneinungen, Dezimalpunkte, Einheiten, Tabellenzellen und Formeln mit dem Original. Ein abgeschlossener Auftrag garantiert nicht, dass diese Details stimmen. Die PDF-Übersetzung erfordert ein kostenloses Konto und Guthaben, akzeptiert Dateien bis 100 MB ohne Seitenlimit und erlaubt einen aktiven PDF-Auftrag pro Konto. Downloads bleiben 24 Stunden verfügbar.
Testdatum, Methode und Einschränkungen (English)