Cómo traducir un PDF escaneado y comprobar si hay errores de OCR
Un PDF escaneado contiene imágenes de páginas en lugar de texto seleccionable. El OCR reconoce los caracteres antes de que comience la traducción. Una traducción puede leerse con fluidez incluso si el OCR ha interpretado mal un número o ha fusionado columnas. Compara siempre el original y el resultado uno al lado del otro.
Elija el siguiente paso según su archivo
| Lo que se observa | Qué hacer a continuación |
|---|---|
| Puede seleccionar el texto y, al pegarlo, los párrafos se leen en orden. | Empiece con el flujo para PDF de texto. Compruebe una tabla o una página densa antes de traducir el archivo completo. |
| No puede seleccionar ningún texto. | Use el flujo para PDF escaneado con OCR. Tras la traducción, coteje los caracteres y las cifras con la imagen. |
| El texto se puede seleccionar, pero las columnas se mezclan al pegarlas. | Pruebe primero esta página. La presencia de una capa de texto no garantiza por sí sola que el orden de lectura sea correcto. |
| Solo algunas páginas están escaneadas. | Incluya en su prueba una página de texto y otra escaneada. Compruebe ambos resultados antes de procesar todo el documento. |
Primero, comprueba qué páginas necesitan OCR
Selecciona una frase y pégala en un editor de texto sin formato. Si no puedes seleccionar ningún texto, es probable que la página necesite OCR. Si el texto pegado es ilegible o fusiona columnas, la capa de texto existente también requiere una inspección minuciosa. Como un PDF puede mezclar páginas de texto y escaneos, comprueba algo más que la primera página.
Prepara una pequeña muestra representativa
Utiliza únicamente páginas que tengas permiso para subir. Para tu primera prueba, incluye una página nítida, una página densa y una página con una tabla. Gira las páginas orientadas de lado y evita el texto recortado. Mantén a salvo tu archivo original. LangBox acepta hasta 100 MB sin límite de páginas, así que divide antes solo los archivos que superen ese tamaño. Ampliar un escaneo borroso no restaurará los caracteres que falten.
Traduce e inspecciona el resultado inicial
Abre el traductor de PDF, inicia sesión, selecciona los idiomas de origen y destino, y sube la muestra. Las páginas escaneadas se procesan mediante el servicio de OCR configurado. Espera a que termine el trabajo y luego compara el resultado bilingüe con el original. Descarga tu archivo en un plazo de 24 horas. Este flujo de trabajo es un servicio en línea y no funciona sin conexión.
Verifica columnas, tablas y cifras
Lee un párrafo completo de principio a fin para detectar columnas fusionadas. Comprueba cada número con su encabezado de fila, encabezado de columna y unidad. Compara signos menos, separadores decimales, fechas y negaciones. Lee las fórmulas directamente del archivo original. En nuestro archivo de prueba archivado, «CC0» se leyó erróneamente como «CCo» y una unidad en chino presentó un salto de línea poco natural a pesar de que el trabajo finalizó sin errores.
Qué hacer si el resultado no es utilizable
Si el texto se superpone, desaparece una columna o cambian los números, no utilices el resultado. Prueba con una fuente autorizada más limpia o una muestra más pequeña e inspecciona el nuevo resultado. Para tablas o fórmulas complejas, básate en el documento original o solicita una revisión humana. Reintentar un archivo puede consumir créditos adicionales y no garantiza un mejor reconocimiento de caracteres.
Qué demuestra este ejemplo
El archivo de prueba descargable contiene una página de texto seleccionable y una página escaneada idéntica, emparejadas con una traducción sin editar. Muestra aciertos y errores específicos en esas páginas exactas. No demuestra la precisión para escritura a mano, escaneos de baja calidad, otros idiomas ni artículos académicos.
Compara archivos PDF originales y resultados reales
Estos son resultados de producción archivados de LangBox del 20 de septiembre de 2026, no pruebas de rendimiento recientes. Abre el original y el resultado sin editar uno al lado del otro. Usa los siguientes ejemplos para valorar si el resultado se adapta a tu documento.
La misma página escaneada
La página 2 es una imagen de la página 1. La repetición final del OCR mantiene los párrafos legibles, pero «CC0» se convierte en «CCo» y la tipografía cambia. Esta repetición de dos páginas utilizó GPT-5.6 Luna y tardó unos 96 segundos. Dado que utilizó un modelo diferente al de la prueba en prosa, no compares estos tiempos como referencia de rendimiento.
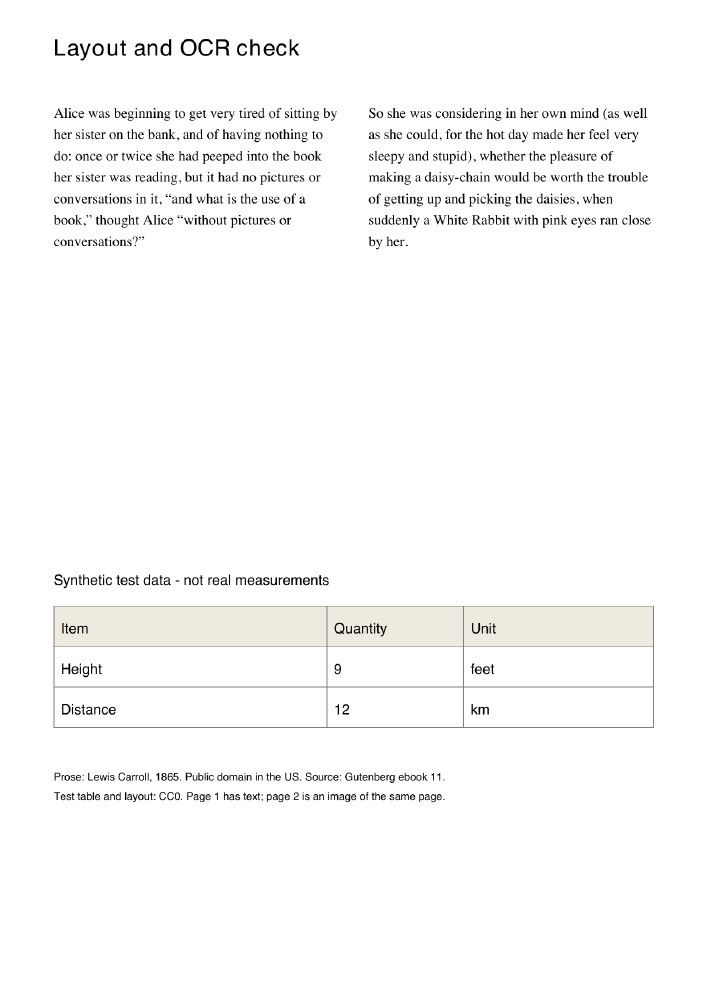
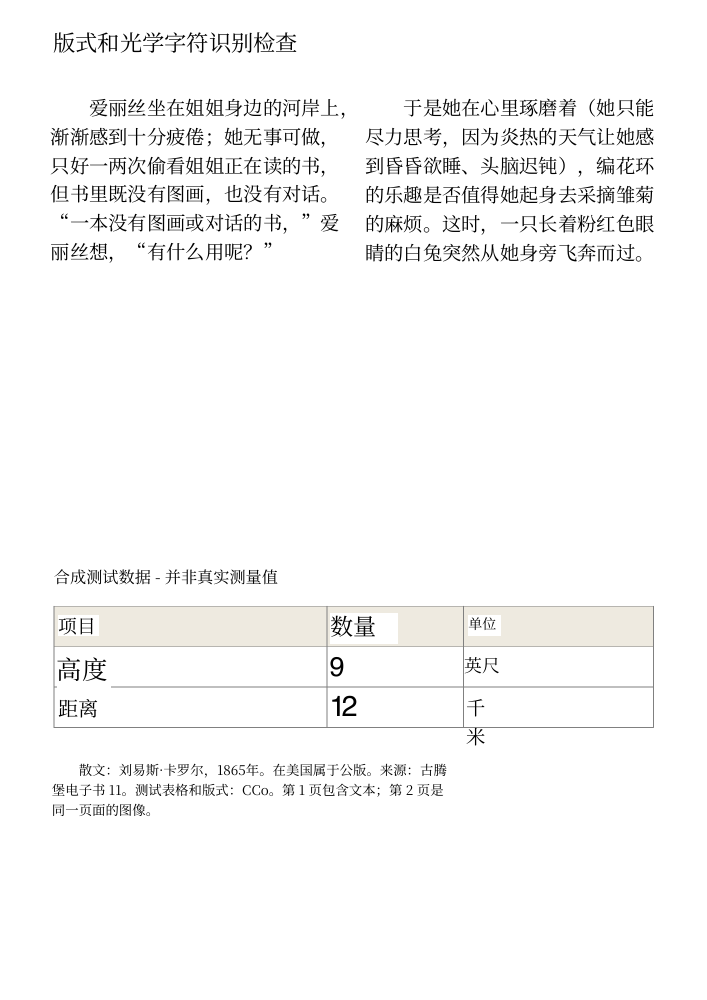
Haga clic en cualquiera de las páginas para abrir su PDF. El original y el resultado visibles pertenecen al mismo caso de diagnóstico archivado.
Comprueba estos detalles antes de confiar en un resultado
Compara nombres, negaciones, separadores decimales, unidades, celdas de tablas y fórmulas con el original. Un trabajo completado no garantiza que estos detalles sean correctos. La traducción de PDF requiere una cuenta gratuita y créditos, acepta archivos de hasta 100 MB sin límite de páginas, y permite una tarea de PDF activa por cuenta. Las descargas permanecen disponibles durante 24 horas.
Fecha de la prueba, método y limitaciones (English)