如何翻译扫描版 PDF 并排查 OCR 错误
扫描版 PDF 包含的是页面图像而非可选中文本。在翻译开始前,OCR 会先识别图像中的字符。即便 OCR 读错了数字或合并了分栏,生成的译文读起来也可能很通顺。请务必将源文件与输出文件并排对照检查。
根据文件情况选择下一步
| 实际现象 | 后续操作 |
|---|---|
| 可以选中文本,且粘贴出的段落顺序正常。 | 先使用文本型 PDF 流程。在翻译整个文件前,先检查包含表格或排版密集的页面。 |
| 无法选中任何文本。 | 使用带 OCR 的扫描版 PDF 流程。翻译后请对照原图检查文字和数字。 |
| 可以选中文本,但粘贴后不同分栏的内容混在一起。 | 先测试该页面。仅有文本层并不能证明阅读顺序正确。 |
| 只有部分页面是扫描件。 | 测试时请同时包含文本页和扫描页。处理整份文档前请先检查这两部分的输出效果。 |
第一步:检查哪些页面需要 OCR
选中一个句子并将其粘贴到纯文本编辑器中。如果无法选中任何文本,则该页面很可能需要 OCR。如果粘贴出来的文本出现乱码或将多栏合并在一起,现有的文本层也需要仔细检查。由于一份 PDF 可能混排了文本页和扫描页,请不要只检查第一页。
准备一份小型的代表性样本
请仅使用您有权上传的页面。进行首次测试时,建议包含一个清晰页面、一个文字密集页面以及一个带表格的页面。请将横向页面旋转放正,并避免文本被裁切。请妥善保管您的原始文件。LangBox 支持最大 100 MB 的文件,不限页数,因此只需预先拆分超过该大小的文件。放大模糊的扫描件并不能恢复缺失的字符。
翻译并检查初步输出结果
打开 PDF 翻译器,登录账户,选择源语言和目标语言,然后上传样本。扫描页面将使用已配置的 OCR 服务进行处理。等待任务完成后,将双语输出与原始文件进行比对。请在 24 小时内下载您的文件。此工作流程为在线服务,不支持离线运行。
核实分栏、表格与数字
从头到尾通读一个完整段落,以排查是否存在分栏合并的问题。对照行标题、列标题和单位检查每一个数字。比对负号、小数点、日期和否定词。公式请直接对照原始文件阅读。在我们的归档测试样本中,尽管任务完成时并未报错,但“CC0”仍被误读为“CCo”,且有一处中文单位换行生硬。
输出结果不可用时的处理方法
如果出现文本重叠、分栏丢失或数字改变的情况,请勿使用该输出结果。请尝试使用更清晰的已授权源文件或缩小样本范围,并检查新的翻译结果。对于复杂的表格或公式,请以原始文档为准或进行人工审校。重试文件可能会消耗额外积分,且不保证能提升字符识别效果。
本示例所证明的内容
可下载的测试样本包含一页可选中文本和一页对应的扫描件,并附有未经编辑的译文。它展示了在这两个特定页面上的具体成功之处与错误案例。它并不能证明手写体、低质量扫描件、其他语言或学术论文的翻译准确性。
对比真实的 PDF 输入与输出文件
这些是记录于 2026 年 9 月 20 日的 LangBox 生产环境归档结果,并非最新的基准测试。请将原始文件与未经编辑的输出文件并排打开进行对比。使用以下示例判断输出效果是否适合您的文档。
同一页面的扫描件
第 2 页是第 1 页的图像扫描件。最终的 OCR 重新运行结果保持了段落的可读性,但“CC0”变成了“CCo”,且字体版式发生了变化。这次针对两页文档的重新运行使用了 GPT-5.6 Luna,耗时约 96 秒。由于使用了与散文测试不同的模型,请勿将这些耗时作为基准测试进行横向对比。
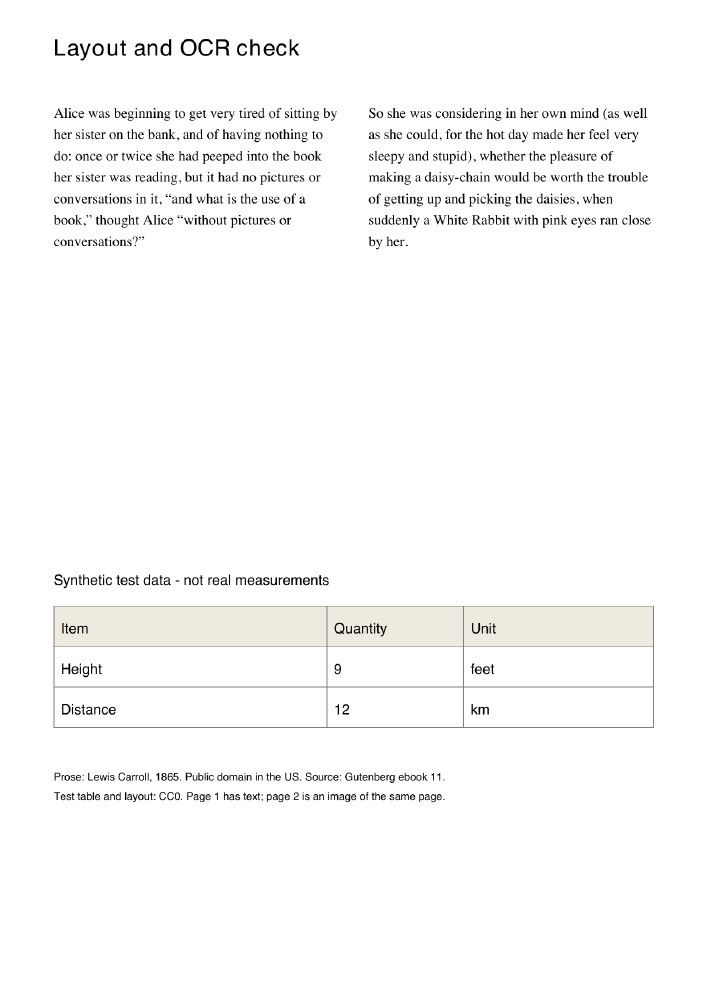
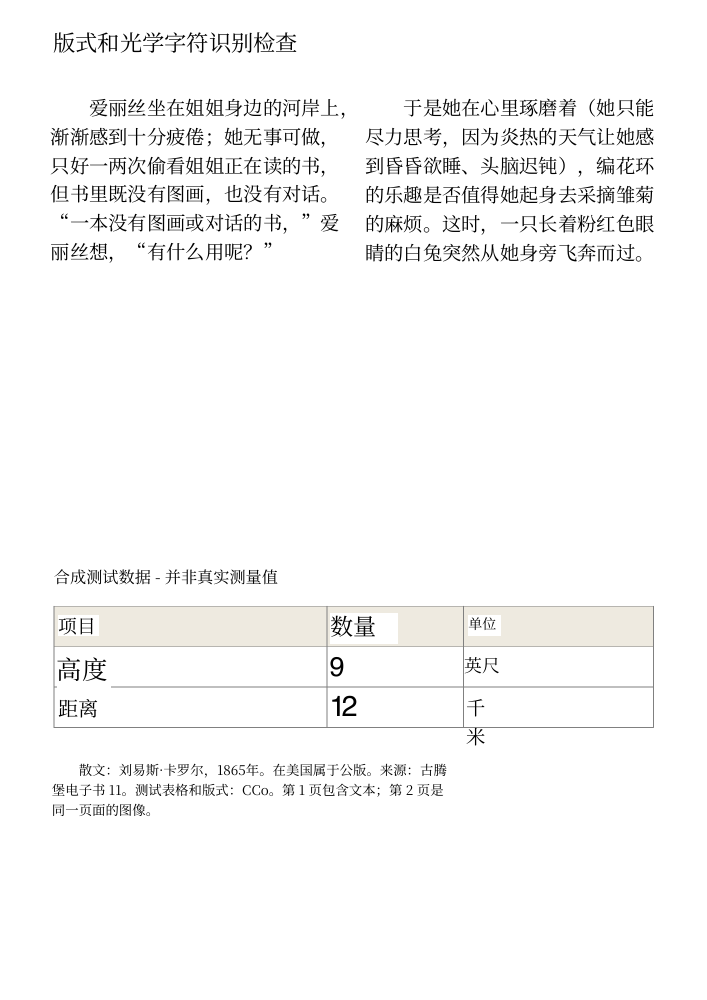
点击任一页面即可打开对应的 PDF。此处显示的原文和导出结果来自同一个归档诊断案例。
采信结果前请核对以下细节
请对照原始文件核对专有名词、否定词、小数点、单位、表格单元格及公式。任务完成并不保证这些细节完全准确。PDF 翻译需要免费账户和可用积分,支持最大 100 MB 的文件,不限页数,每个账户同时只能运行一个活跃的 PDF 任务。下载链接在 24 小时内有效。
测试日期、方法与局限性 (English)